
Visual Autoregressive Modeling: ¿Y si las imágenes se generaran de la misma manera que el lenguaje?
 |
|---|
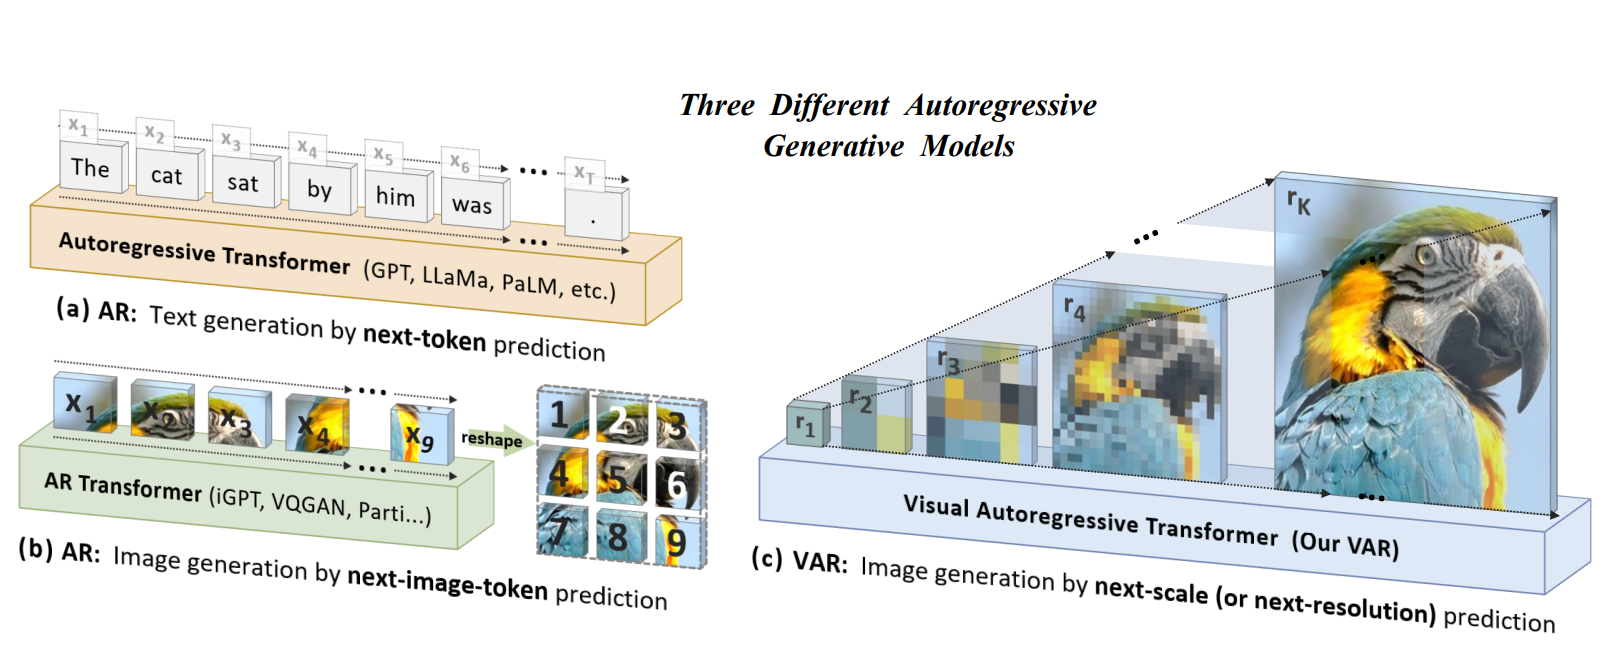
| Visual Autoregressive Modeling (VAR). Imagen importada de “Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction” (2024).* |
Durante los últimos años, los modelos autoregresivos han demostrado una capacidad extraordinaria para modelar distribuciones complejas. Los Large Language Models (LLMs), como GPT, han popularizado un paradigma de aprendizaje aparentemente sencillo: dado un contexto, es posible predecir el siguiente token. Repitiendo este procedimiento, el modelo puede construir secuencias de lenguaje coherentes y de longitud arbitraria.
Este principio también se ha trasladado al dominio visual. Si un modelo puede aprender a generar una secuencia de palabras, ¿por qué no podría aprender a generar una secuencia de representaciones visuales y, eventualmente, construir una imagen completa?
Esta idea no es nueva. Modelos como VQ-VAE y VQGAN demostraron que era posible representar imágenes mediante secuencias de tokens discretos y utilizar Transformers autoregresivos para generar nuevas imágenes. Sin embargo, a pesar de su similitud conceptual con los LLMs, estos modelos presentaban limitaciones importantes en calidad de generación, eficiencia computacional y escalabilidad.
 |
|---|
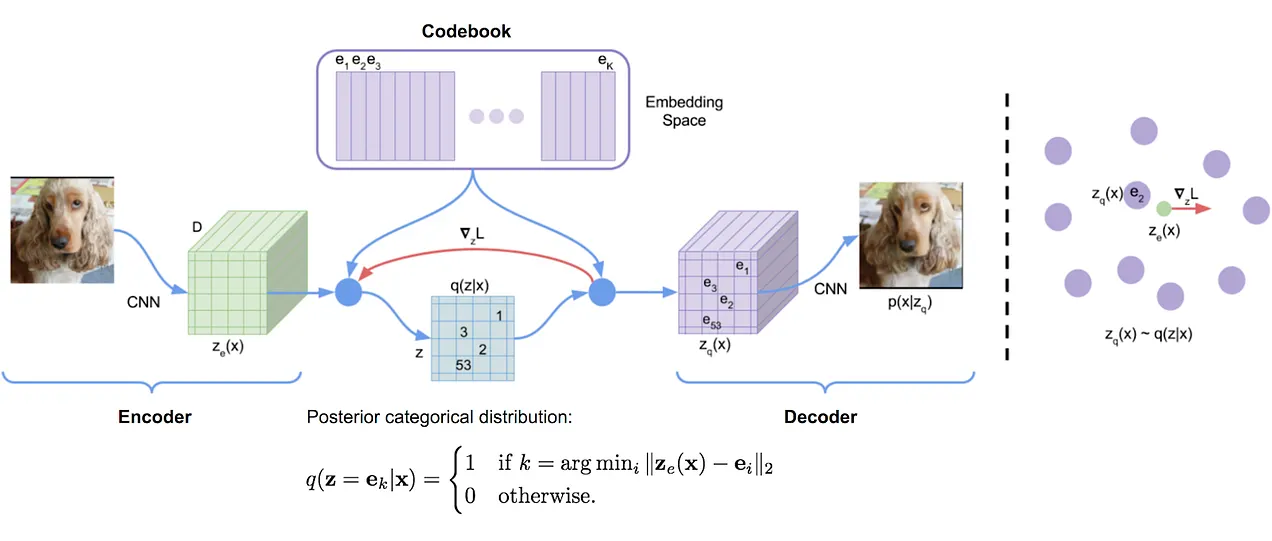
| VQ-VAE. Imagen importada de “Neural Discrete Representation Learning” (2017). |
En 2024, Tian et. al. presentaron “Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction”, un trabajo aceptado en NeurIPS 2024 y posteriormente reconocido con el premio Best Paper.
La contribución central del trabajo es una modificación aparentemente sencilla, pero conceptualmente importante: en lugar de predecir el siguiente token visual, el modelo aprende a predecir la siguiente escala de resolución de una imagen.
Esta estrategia, denominada Next-Scale Prediction, permite replantear la generación autoregresiva desde una perspectiva jerárquica y multiescala. Veamos cómo funciona.
1. El problema de generar imágenes de manera autoregresiva
Para comprender la propuesta de VAR, primero debemos entender cómo se aplica tradicionalmente el modelado autoregresivo a imágenes.
En un modelo autoregresivo convencional, la distribución conjunta de una secuencia de tokens puede factorizarse mediante la regla de la cadena:
\[p(\mathbf{x}) = \prod_{t=1}^{T} p(x_t \mid x_1,x_2,\ldots,x_{t-1}).\]Esta expresión establece que cada token se genera condicionado a todos los tokens anteriores.
En los modelos de lenguaje, esto resulta bastante intuitivo. Por ejemplo, al generar una oración, el modelo predice una palabra o token a partir del contexto previamente generado.
Pero las imágenes presentan una diferencia fundamental: no poseen un orden secuencial natural. Una imagen es una señal bidimensional cuyos elementos presentan fuertes dependencias espaciales. Por ejemplo, los píxeles de una región suelen estar relacionados con sus vecinos, y las diferentes regiones de una imagen contribuyen conjuntamente a definir su estructura semántica.
Para aplicar un modelo autoregresivo convencional, necesitamos transformar la imagen en una secuencia.
1.1. De imágenes a tokens visuales
Una estrategia habitual consiste en utilizar un autoencoder cuantizado, como VQ-VAE o VQGAN.
El encoder transforma la imagen original en un mapa de características:
\[\mathbf{f} = \mathcal{E}(\mathbf{x}),\]donde $\mathbf{x}\in\mathbb{R}^{H\times W\times C}$ representa la imagen y $\mathbf{f}$ su representación latente. $H$, $W$ y $C$ son la altura, el ancho y el número de canales de la imagen, respectivamente.
Posteriormente, un cuantizador vectorial (Vector Quantization) asigna cada vector de características a la entrada más cercana de un codebook aprendido:
\[q_{i,j} = \underset{v\in{1,\ldots,V}}{\operatorname{argmin}} \left| \mathbf{f}_{i,j}-\mathbf{e}_v \right|_2^2,\]donde $\mathbf{e}_v$ representa el vector asociado al índice $v$ dentro del codebook.
El resultado es un mapa de tokens discretos:
\[\mathbf{q}\in{1,\ldots,V}^{h\times w}.\]Por ejemplo, si el mapa latente tiene resolución $16\times16$, obtenemos 256 tokens visuales.
Para aplicar un Transformer autoregresivo tradicional, este mapa bidimensional se aplana siguiendo un orden raster-scan, es decir, de izquierda a derecha y de arriba hacia abajo:
\[\mathbf{q} \longrightarrow (q_1,q_2,\ldots,q_{hw}).\]A partir de aquí, el problema parece equivalente al modelado del lenguaje: predecir el siguiente token condicionado a los anteriores.
Sin embargo, esta transformación introduce varias dificultades.
1.2. ¿Por qué el orden raster-scan resulta problemático?
Existen al menos tres limitaciones importantes.
1. Dependencias espaciales restringidas.
El modelo únicamente puede acceder a los tokens anteriores. Por tanto, durante la generación de una región determinada, no puede utilizar información de las regiones que todavía no han sido generadas.
Esto restringe la capacidad de modelar determinadas relaciones espaciales bidireccionales.
2. Pérdida de estructura espacial.
Al convertir un mapa bidimensional en una secuencia unidimensional, se altera la representación explícita de las relaciones espaciales. Dos tokens próximos en la imagen no necesariamente conservan una relación equivalente en la secuencia resultante.
3. Ineficiencia durante la generación
Este es posiblemente uno de los problemas más importantes.
Si una imagen requiere generar $T$ tokens, un modelo autoregresivo convencional necesita realizar $T$ pasos secuenciales de generación. Incluso si cada paso utiliza un Transformer altamente optimizado, la dependencia secuencial limita el paralelismo durante la inferencia.
En consecuencia, surge una pregunta interesante: ¿Es realmente necesario generar una imagen token por token?
2. Next-Scale Prediction
La principal contribución de Visual Autoregressive Modeling consiste en cambiar la unidad de predicción.
En lugar de generar un único token visual en cada paso, VAR genera un mapa completo de tokens correspondiente a una determinada escala de resolución.
La intuición es sencilla: una imagen puede construirse progresivamente, comenzando por su estructura global y añadiendo detalles a medida que aumenta la resolución.
Pensemos en el proceso de dibujar un paisaje. Primero establecemos la composición general: el cielo, las montañas y el horizonte. Posteriormente incorporamos elementos más pequeños, como árboles, edificios, texturas y otros detalles.
VAR adopta una estrategia computacional inspirada en esta construcción jerárquica.
2.1. Representación multiescala
En lugar de representar una imagen mediante un único mapa de tokens, VAR utiliza un conjunto de mapas discretos a diferentes resoluciones:
\[\mathcal{R} = (\mathbf{r}_1,\mathbf{r}_2,\ldots,\mathbf{r}_K).\]Cada representación tiene una resolución progresivamente mayor:
\[h_1\times w_1 < h_2\times w_2 < \cdots < h_K\times w_K.\]La primera escala representa la estructura más global de la imagen, mientras que las siguientes incorporan información espacial cada vez más detallada.
Por ejemplo, podemos considerar una secuencia simplificada de resoluciones:
\[1\times1 \rightarrow 2\times2 \rightarrow 4\times4 \rightarrow 8\times8.\]En este caso, el modelo no genera 85 tokens de manera secuencial. Genera cuatro mapas de tokens, uno por cada escala.
Es importante destacar que cada mapa contiene múltiples tokens y que estos se predicen en paralelo dentro de su correspondiente escala.
2.2. Formulación matemática
La distribución conjunta de las representaciones multiescala se factoriza de la siguiente manera:
\[p(\mathcal{R})=\prod_{k=1}^{K} p(\mathbf{r}_k\mid \mathbf{r}_1,\ldots,\mathbf{r}_{k-1}).\]Esta expresión constituye el fundamento probabilístico del modelo.
En cada paso, el Transformer estima la distribución de la siguiente representación multiescala condicionada a todas las escalas anteriores.
Por tanto, el proceso de generación puede describirse como:
\[\mathbf{r}1\sim p_\theta(\mathbf{r}_1),\] \[\mathbf{r}2\sim p_\theta(\mathbf{r}_2\mid\mathbf{r}_1),\] \[\vdots\] \[\mathbf{r}_K\sim p\theta(\mathbf{r}_K\mid \mathbf{r}_1,\ldots,\mathbf{r}_{K-1}).\]La diferencia fundamental con el modelado autoregresivo tradicional es que ahora la unidad autoregresiva no es un token individual, sino un mapa completo de tokens.
2.3. ¿Cómo se preservan las dependencias entre escalas?
Para conseguirlo, los autores utilizan una arquitectura Transformer de tipo decoder-only, inspirada en GPT-2, junto con una máscara de atención causal por bloques.
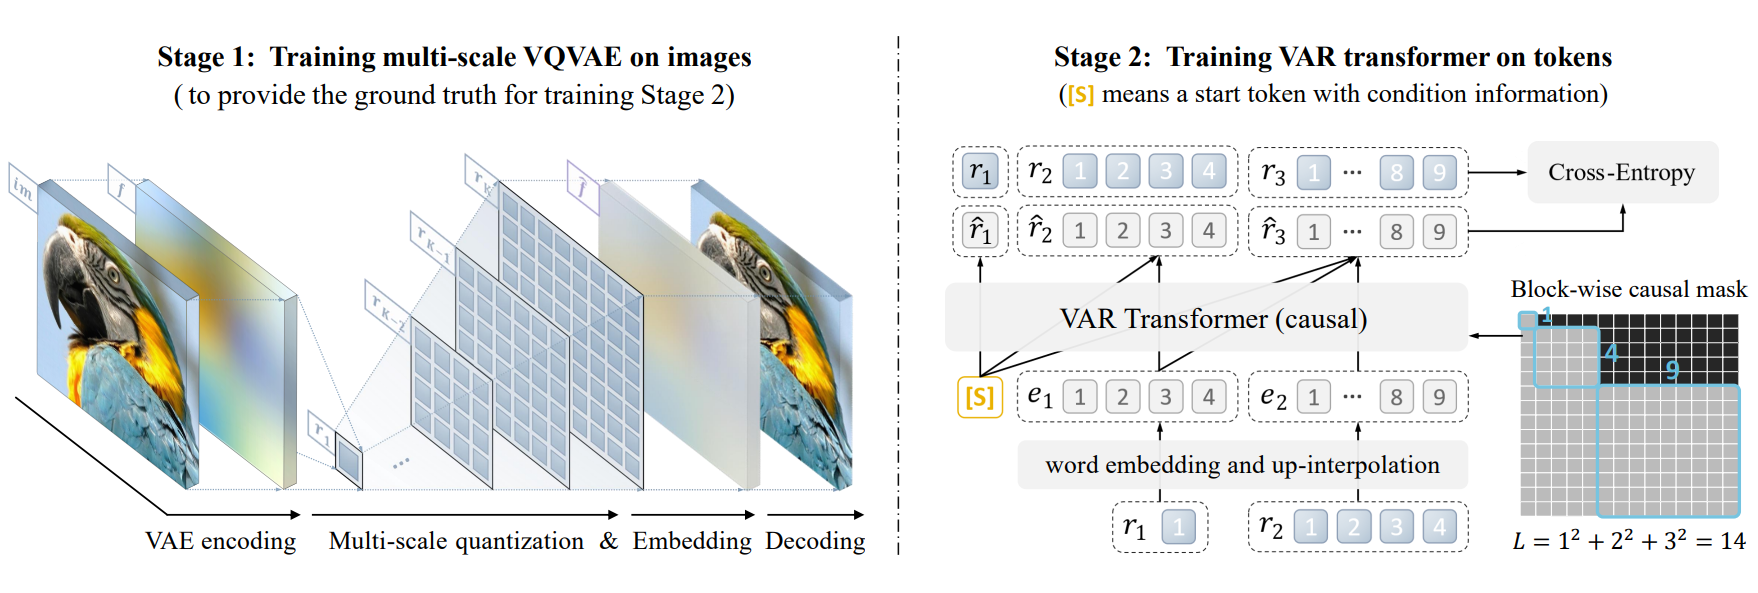
Esta máscara impone que los tokens de una escala únicamente puedan atender a las representaciones correspondientes a escalas anteriores y a su propia escala.
En otras palabras:
- La escala 1 no depende de ninguna escala anterior.
- La escala 2 puede atender a la escala 1 y a sí misma.
- La escala 3 puede atender a las escalas 1 y 2, además de a sí misma.
- La escala $k$ puede atender a todas las escalas $j\leq k$.
La máscara permite mantener la naturaleza autoregresiva del modelo sin imponer una generación secuencial entre todos los tokens de una misma escala. Es decir, VAR mantiene la dependencia causal entre escalas, pero permite la generación paralela dentro de cada escala.
3. ¿Cómo se construyen las representaciones multiescala?
Una de las contribuciones técnicas más interesantes del trabajo es el diseño de un tokenizer basado en VQ-VAE con cuantización multiescala.
No basta con obtener diferentes versiones reducidas de una imagen. Las representaciones deben estar relacionadas de manera que cada nueva escala incorpore información adicional respecto a las anteriores.
Para conseguirlo, los autores introducen un mecanismo de cuantización residual.
3.1. Cuantización residual multiescala
Primero, el encoder transforma la imagen original en un mapa de características:
\[\mathbf{f}=\mathcal{E}(\mathbf{x}).\]A continuación, se inicializa una representación residual:
\[\mathbf{f}_1=\mathbf{f}.\]En cada escala $k$, se realiza el siguiente procedimiento:
-
Se adapta la resolución del mapa residual a la resolución correspondiente.
-
Se cuantiza utilizando un codebook compartido.
-
Se recuperan los embeddings asociados a los índices seleccionados.
-
Se interpolan los embeddings a la resolución final.
-
Una transformación convolucional produce una contribución residual que se sustrae del mapa anterior.
Matemáticamente, podemos expresar la actualización residual como:
\[\mathbf{z}_k := \operatorname{Lookup} \left( \mathcal{Q}( \operatorname{Resize}(\mathbf{f}_k,h_k,w_k)) \right),\] \[\mathbf{f}:=\mathbf{f}- \phi_k\left( \operatorname{Resize}(\mathbf{z}_k,h_K,w_K) \right),\]donde $\mathcal{Q}$ representa el cuantizador, $\phi_k$ una transformación convolucional específica de la escala y $\operatorname{Resize}$ la operación de interpolación espacial.
Este procedimiento permite que las primeras escalas capturen información global, mientras que las escalas posteriores se concentran progresivamente en los componentes residuales que todavía no han sido representados.
Una característica importante es que VAR utiliza un codebook compartido entre todas las escalas. De esta manera, los códigos discretos pertenecen al mismo vocabulario visual.
3.2. Dos etapas de entrenamiento
La arquitectura completa se entrena en dos etapas independientes.
 |
|---|
| VQ-VAE se entrena para reconstruir la imagen original a partir de sus embeddings multiescala. VAR se entrena para predecir cada escala condicionada a las anteriores. Imagen importada de “Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction” (2024).* |
Primera etapa: entrenamiento del tokenizer multiescala.
Se entrena el autoencoder cuantizado para obtener representaciones discretas a diferentes resoluciones y reconstruir la imagen original.
El objetivo combina términos de reconstrucción, cuantización y pérdidas perceptuales.
Segunda etapa: entrenamiento del Transformer autoregresivo.
Una vez entrenado el tokenizer, se utiliza para transformar las imágenes del conjunto de datos en secuencias de mapas multiescala.
El Transformer aprende a predecir cada escala condicionada a las anteriores, utilizando una función de pérdida basada en entropía cruzada:
\[\mathcal{L}(\theta)=-\sum_{k=1}^{K} \log p_\theta (\mathbf{r}_k\mid \mathbf{r}1,\ldots,\mathbf{r}{k-1}).\]Esta formulación corresponde a la suma de las pérdidas de predicción de las diferentes escalas.
4. Generación de imágenes: de la estructura global a los detalles
Una vez entrenado el modelo, la generación comienza a partir de un token de inicio que incorpora la información de condicionamiento.
En el caso de generación condicionada por clases de ImageNet, este token se construye a partir del embedding de la clase correspondiente.
Posteriormente, el Transformer genera las representaciones multiescala de manera progresiva.
El procedimiento puede resumirse así:
-
Se introduce el token de inicio ([SOS]) y se genera la primera escala.
-
La primera representación se utiliza como contexto para predecir la segunda escala.
-
Se incorporan las nuevas representaciones y se predice la siguiente escala.
-
El proceso continúa hasta alcanzar la resolución final.
-
Finalmente, el decoder del VQ-VAE reconstruye la imagen a partir de los embeddings cuantizados de todas las escalas.
Es importante mencionar que, aunque las escalas se generan secuencialmente, los tokens de cada escala se predicen en paralelo. Para lograr esto, el modelo utiliza una máscara de atención causal por bloques que permite que los tokens de una escala puedan atender a todos los tokens de escalas anteriores y a los tokens de su propia escala. Los embeddings generados en la escala $j$ se utilizan como contexto para predecir la escala $j+1$ mediante la interpolación de los embeddings hacia la resolución en $j+1$.
Esta característica reduce significativamente el número de iteraciones autoregresivas necesarias durante la inferencia.
Referencias
Tian, K., Jiang, Y., Yuan, Z., Peng, B., & Wang, L. (2024). Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction. Advances in Neural Information Processing Systems (NeurIPS 2024).
Paper: https://arxiv.org/abs/2404.02905
Código oficial: https://github.com/FoundationVision/VAR