
El Patrón Oculto en los Modelos Generativos
Aunque hoy en día el término “IA generativa” es omnipresente, la realidad es que los modelos que impulsan esta tecnología no son nuevos. De hecho, muchos de ellos se basan en ecuaciones y principios matemáticos que han existido durante décadas. Modelo tras modelo han desfilado por mis retinas, y he notado un patrón recurrente—no soy el único obviamente. Los modelos generativos tienen como objetivo generar datos artificiales que simulen las características de los datos reales con los que fueron entrenados. Este objetivo se logra mediante el uso de diversas arquitecturas y diferentes técnicas de entrenamiento, ¿O no es así?
A pesar de tener nombres y arquitecturas distintas, diversos estudios muestran que la mayoría de estos modelos comparten una misma ecuación fundamental. En este artículo desglosaré algunos de los modelos generativos más conocidos y demostraré cómo todos ellos se apoyan en una misma ecuación fundamental subyacente.
Los Variational Autoencoders (VAEs)
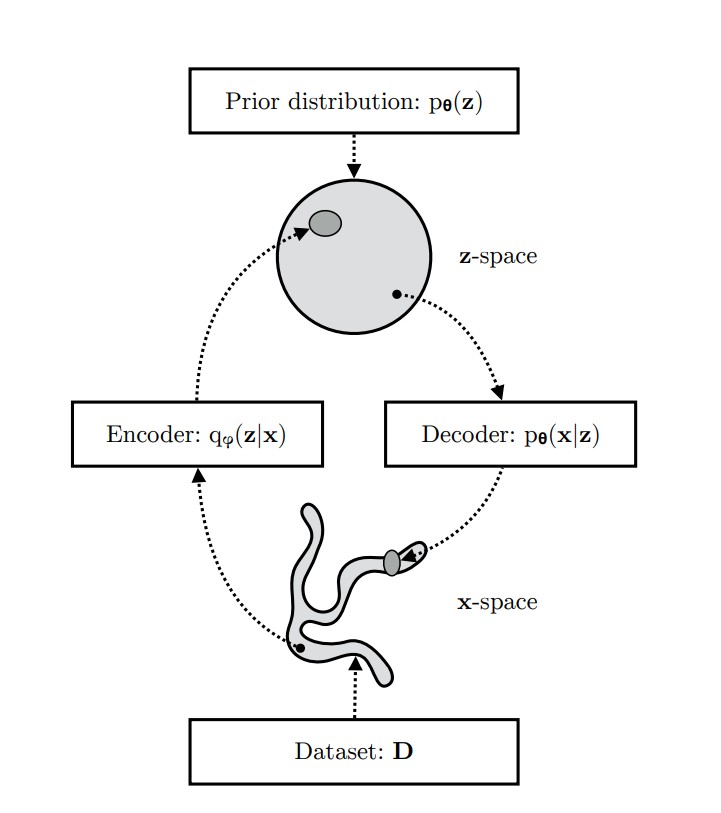
Voy a empezar con los Variational Autoencoders, que utilizan como función de pérdida el ELBO (Evidence Lower Bound Objective). Es decir la función de pérdida que minimizan los VAEs es una cota inferior del log-likelihood de los datos observados. Antes de profundizar en la ecuación, recordemos la arquitectura básica de una VAE.
 |
|---|
| Variational Autoencoders. Imagen importada de An Introduction to Variational Autoencoders (Kingma and Welling,2019). |
En un VAE, se plantea el escenario en el cual los datos observados $\mathbf{x}$ son generados a partir de una variable latente $\mathbf{z}$ (no observada). El proceso empieza generando $\mathbf{z}$ a partir de una distribución previa $p_{\theta}(\mathbf{z})$, y luego generando $\mathbf{x}$ a partir de la distribución condicional $p_{\theta}(\mathbf{x}|\mathbf{z})$, donde $\theta$ representa los parámetros del modelo. El objetivo es encontrar el valor óptimo ${\theta}^*$ que maximiza la probabilidad de los datos observados. Para ello, existen dos enfoques:
La primera opción sería maximar directamente el log-likelihood de los datos observados:
\[\log p_{\theta}(\mathbf{x}) = \int p_{\theta}(\mathbf{x}|\mathbf{z})p_{\theta}(\mathbf{z})d\mathbf{z}.\]Sin embargo, esta integral es intratable debido a la alta dimensionalidad del espacio latente $\mathbf{z}$. Por lo tanto, se utiliza una segunda opción que consiste en maximar una cota inferior del log-likelihood conocida como ELBO. Razón por la cual se intruduce el modelo variacional $q_{\phi}(\mathbf{z}|\mathbf{x})$—variacional porque su objetivo es aproximar la distribución posterior $p_{\theta}(\mathbf{z}|\mathbf{x})$. La distribución posterior es crucial porque nos permite inferir las variables latentes $\mathbf{z}$ a partir de los datos observados $\mathbf{x}$.
Sabemos que la integración de la densidad $q_{\phi}(\mathbf{z}|\mathbf{x})$ sobre todo el espacio latente debe ser igual a uno, es decir $\int q_{\phi}(\mathbf{z}|\mathbf{x})d\mathbf{z}=1$. Utilizando esta propiedad, podemos derivar la siguiente identidad:
\[\log p_{\theta}(\mathbf{x}) = \log p_{\theta}(\mathbf{x}) \int q_{\phi}(\mathbf{z}|\mathbf{x})d\mathbf{z} = \int q_{\phi}(\mathbf{z}|\mathbf{x}) \log p_{\theta}(\mathbf{x}) d\mathbf{z}.\]Por la definición de Esperanza Matemática, podemos reescribir la ecuación anterior como:
\[\log p_{\theta}(\mathbf{x}) = \mathbf{E}_{q_{\phi}(\mathbf{z}|\mathbf{x})} \left[ \log p_{\theta}(\mathbf{x}) \right].\]Aplicando el Teorema de Bayes y múltiplicando el númerador y denominador por $q_{\phi}(\mathbf{z}|\mathbf{x})$, obtenemos:
\[\log p_{\theta}(\mathbf{x}) = \mathbf{E}_{q_{\phi}(\mathbf{z}|\mathbf{x})} \left[ \log \frac{p_{\theta}(\mathbf{x},\mathbf{z})}{q_{\phi}(\mathbf{z}|\mathbf{x})} \right] + \text{D}_{\text{KL}}\left( q_{\phi}(\mathbf{z}|\mathbf{x}) \| p_{\theta}(\mathbf{z}|\mathbf{x}) \right),\]donde $\text{D}_{\text{KL}}$ representa la divergencia de Kullback-Leibler, una medida de disimilitud entre dos distribuciones de probabilidad. Esta divergencia es siempre mayor o igual a cero, es decir:
\[\log p_{\theta}(\mathbf{x}) \geq \mathbf{E}_{q_{\phi}(\mathbf{z}|\mathbf{x})} \left[ \log \frac{p_{\theta}(\mathbf{x},\mathbf{z})}{q_{\phi}(\mathbf{z}|\mathbf{x})} \right].\]Bingo! Hemos llegado a la definición del ELBO—el término en el lado derecho de la desigualdad. Analizemos esta desigualdad. Si definimos $\mathcal{L}(\phi,\theta)$ como el $\text{ELBO}$, tenemos que:
- $\log p_{\theta}(\mathbf{x}) \geq \mathcal{L}(\phi,\theta)$.
- $\log p_{\theta}(\mathbf{x})$ no depende de $\phi$.
- La brecha o diferencia entre $\log p_{\theta}(\mathbf{x})$ y $\mathcal{L}(\phi,\theta)$ es la divergiencia KL entre el modelo variacional y la distribución posterior verdadera.
- Al maximizar el ELBO, estamos minimizando la divergencia KL entre el modelo variacional y la distribución posterior verdadera. Es decir, estamos haciendo que $q_{\phi}(\mathbf{z}|\mathbf{x})$ se aproxime a $p_{\theta}(\mathbf{z}|\mathbf{x})$.
Por lo tanto:
- Al máximizar el ELBO con respecto a $\theta$, maximizamos indirectamente el log-likelihood de los datos observados $\log p_{\theta}(\mathbf{x})$.
- Al maximizar el ELBO con respecto a $\phi$, hacemos que el modelo variacional $q_{\phi}(\mathbf{z}|\mathbf{x})$ produzca variables latentes $\mathbf{z}$ coherentes con los datos observados $\mathbf{x}$.
Me gustaría detenerme aquí y no continuar con la derivación completa de la función de pérdida del VAE. Sin embargo, si el lector esta interesado en ver la derivación completa, puedes consultar el paper original aquí.
Los Variational Autoencoders se presentaron por primera vez en 2013 por Kingma y Welling, y desde entonces han sido la base para muchos avances en el campo de los modelos generativos. Aunque los VAEs se hicieron muy populares debido a su capacidad para generar datos de alta calidad, rápidamente fueron opacados por otro tipo de modelos generativos: los Generative Adversarial Networks (GANs). El reynado de las GANs duró varios años lo cual pudo llevar a pensar que el estudio de las VAEs había llegado a su fin. Sin embargo, en el 2016 se planteó utilizar una versión jerarquica de los Variational Autoencoders, conocidos como Ladder VAEs (LVAEs). Me gustaría discutir brevemente este modelo, ya es importante para nuestro análisis posterior.
Hierarchical Variational Autoencoders (HVAEs)
En una VAE, $q_{\phi}(\mathbf{z}|\mathbf{x})$ se modelo típicamente por una red neuronal $\mathcal{E}$ que toma como entrada los datos observados $\mathbf{x}$ y produce los parámetros de la distribución de las variables latentes $\mathbf{z}$. Y luego, $p_{\theta}(\mathbf{x}|\mathbf{z})$ se modela por otra red neuronal $\mathcal{D}$ que toma como entrada las variables latentes $\mathbf{z}$ y produce los datos reconstruidos $\hat{\mathbf{x}}$. En una VAE estándar, existe únicamente una capa de variables latentes $\mathbf{z}$. Sin embargo, en una HVAE, se introducen múltiples capas de variables latentes jerárquicas $\mathbf{z}_1, \mathbf{z}_2, \ldots, \mathbf{z}_T$ como se muestra en la siguiente figura: